
Reflexion:用语言反馈让智能体从失败中学习
Reflexion: Language Agents with Verbal Reinforcement Learning
- 发表日期
- 机构
- Northeastern University × MIT × Princeton University
- 作者
- 6 位
展开全部作者(6)
Noah Shinn · Federico Cassano · Edward Berman · Ashwin Gopinath · Karthik Narasimhan · Shunyu Yao
0
梯度更新 / 参数微调
3
Actor / Evaluator / Reflection
1–3
长期记忆中的近期经验
130/134
ALFWorld 完成任务
91.0%
HumanEval Python pass@1
+20pt
HotPotQA ReAct 绝对提升
TL;DR · 60 秒速览
这篇论文到底说了什么
Reflexion 的关键不是让模型多想一遍,而是把「行动 → 评价 → 复盘 → 再行动」做成跨试次闭环:Evaluator 判断失败,Self-Reflection 把稀疏奖励和失败轨迹翻译成可执行的文字经验,Actor 在下一次尝试时读取这些经验。整个过程不更新模型权重,却在 HumanEval Python 上把 GPT-4 单次生成的 80.1% 提到 91.0%,在 ALFWorld 解出 130/134 个任务。真正的边界同样重要:MBPP Python 反而下降到 77.1%,WebShop 无显著提升,弱模型也不会因“反思”自动变强——它依赖可靠评价、可修正的错误和足够强的自我诊断能力。
摘要(编译)
大语言模型正被用于与游戏、编译器和 API 等外部环境交互,但传统强化学习需要大量样本与昂贵微调,语言智能体难以快速从试错中学习。本文提出 Reflexion:不更新模型权重,而是让智能体根据任务反馈生成自然语言反思,并把反思写入情景记忆,以影响后续试次的决策。该框架可接收标量或自由文本、外部或内部模拟的反馈,并在序列决策、知识推理和代码生成任务上优于基线。论文同时比较了不同反馈来源、记忆方式和智能体类型,说明改进来自“评价 + 语言化归因 + 持久记忆”的组合,而不是盲目重试。
01 · The Problem
重试不等于学习:失败之后,Agent 还缺一条语义梯度
语言智能体通常能执行动作,却很难从一次失败迁移到下一次尝试。普通 ReAct 在环境中走错后可以重置,但如果下一轮上下文里没有保留下来一条明确经验,它大概率会重新犯同样的错;传统强化学习可以更新策略权重,却需要训练样本、梯度计算和模型微调,无法在部署现场用几次试错快速适应。
Reflexion 的切入点是:LLM 的策略不仅由模型参数决定,也由它读到的记忆决定。既然模型已经能理解自然语言,就可以把一个稀疏的 0/1 奖励“放大”为具体诊断——哪里错、为什么错、下次该怎么做——再把这段诊断作为下一轮的上下文。作者把它称为 semantic gradient(语义梯度):它提供改进方向,但不做反向传播。
Reflexion 不是给同一个答案追加一句“请反思”,而是让失败经过评价、归因和记忆,真正进入下一次策略条件。
02 · Architecture
三种角色,一个跨试次学习闭环
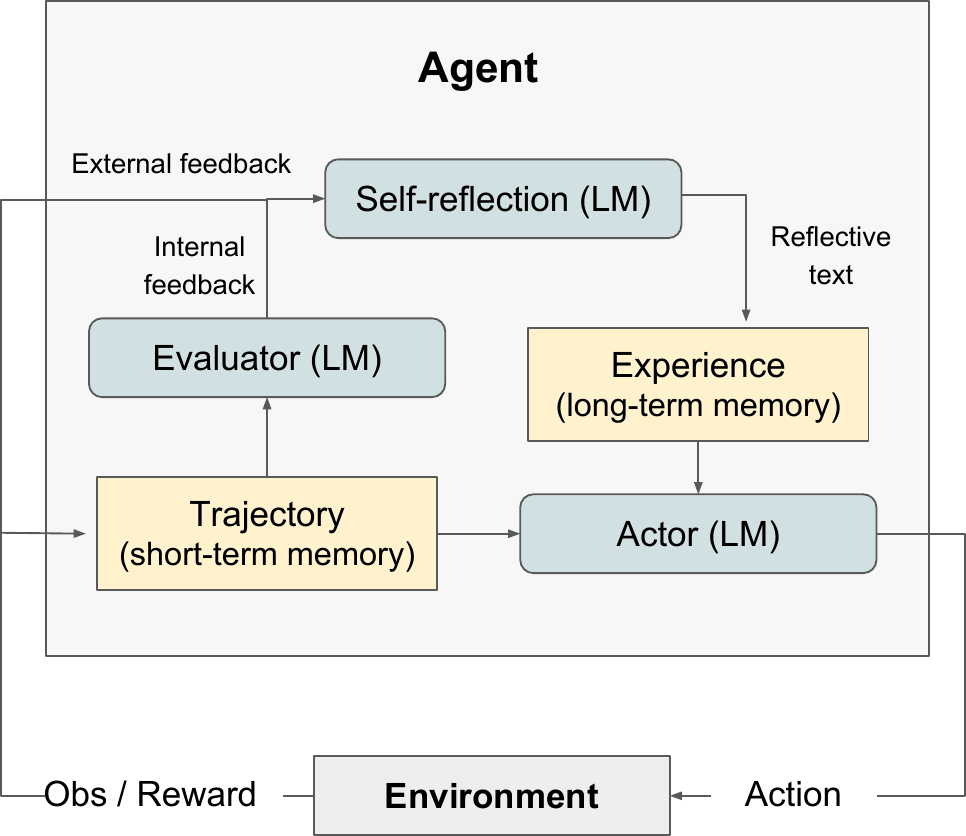
框架由三个可独立实例化的模型组成。Actor 根据当前观察、短期轨迹与长期经验生成动作;Evaluator 对完整轨迹给出奖励或通过/失败判断;Self-Reflection 接收轨迹、奖励和已有记忆,生成一段面向未来的文字经验。经验写入 mem 后,环境重置,Actor 再尝试,直到通过或达到试次上限。
Evaluator 可以是环境精确匹配、手写启发式,也可以是另一个 LLM;反馈既可以来自外部环境,也可以由智能体内部模拟。模块化带来的是可替换性,也暴露了关键依赖:Evaluator 如果判断错,Reflection 会把错误信号包装成更有说服力的错误经验。
πθ(aᵢ | sᵢ), θ = {Mₐ, mem}; mem ← mem ⊕ srₜ策略的可变部分是文字记忆 mem;Mₐ 的权重不更新。srₜ 由当前轨迹与评价生成,并在后续试次作为长期经验进入上下文。
03 · Memory
反思真正解决的是压缩与信用分配
论文把记忆分成两层:当前试次的完整 trajectory 是短期记忆,保留细粒度动作与观察;Self-Reflection 生成的 experience 是长期记忆,把冗长失败压缩成少量、第一人称、可执行的教训。Actor 同时读取两者,于是既知道刚刚发生了什么,也知道过去几轮总结出了什么。
这一步比保留上一条完整轨迹更重要。HotPotQA 消融中,仅加入最近轨迹的 episodic memory 已有增益,但再加入语言化自我反思还能获得 8 个百分点的绝对提升。换句话说,价值不只在“记住”,而在于从大量 token 中做信用分配:把结果追溯到某个错误假设或错误动作。
为控制上下文,论文把长期记忆限制为滑动窗口:ALFWorld 与 HotPotQA 最多保留最近 3 条反思,代码生成只保留 1 条。这是一种轻量工程折中,并不是完备记忆系统;作者也把向量数据库或 SQL 等更高级记忆结构留作未来工作。
04 · ALFWorld
序列决策:把长轨迹中的早期错误变成下一轮提示
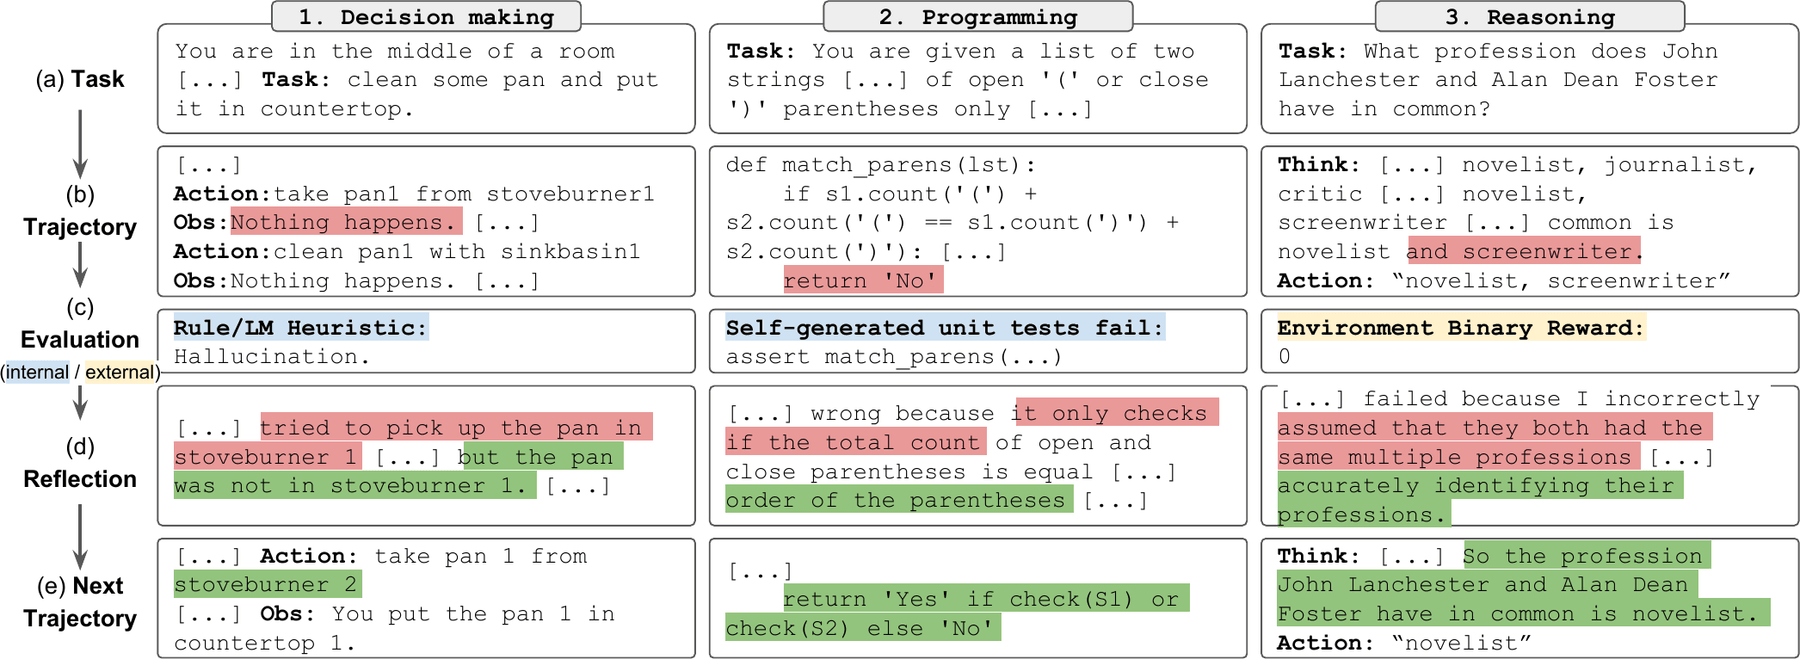
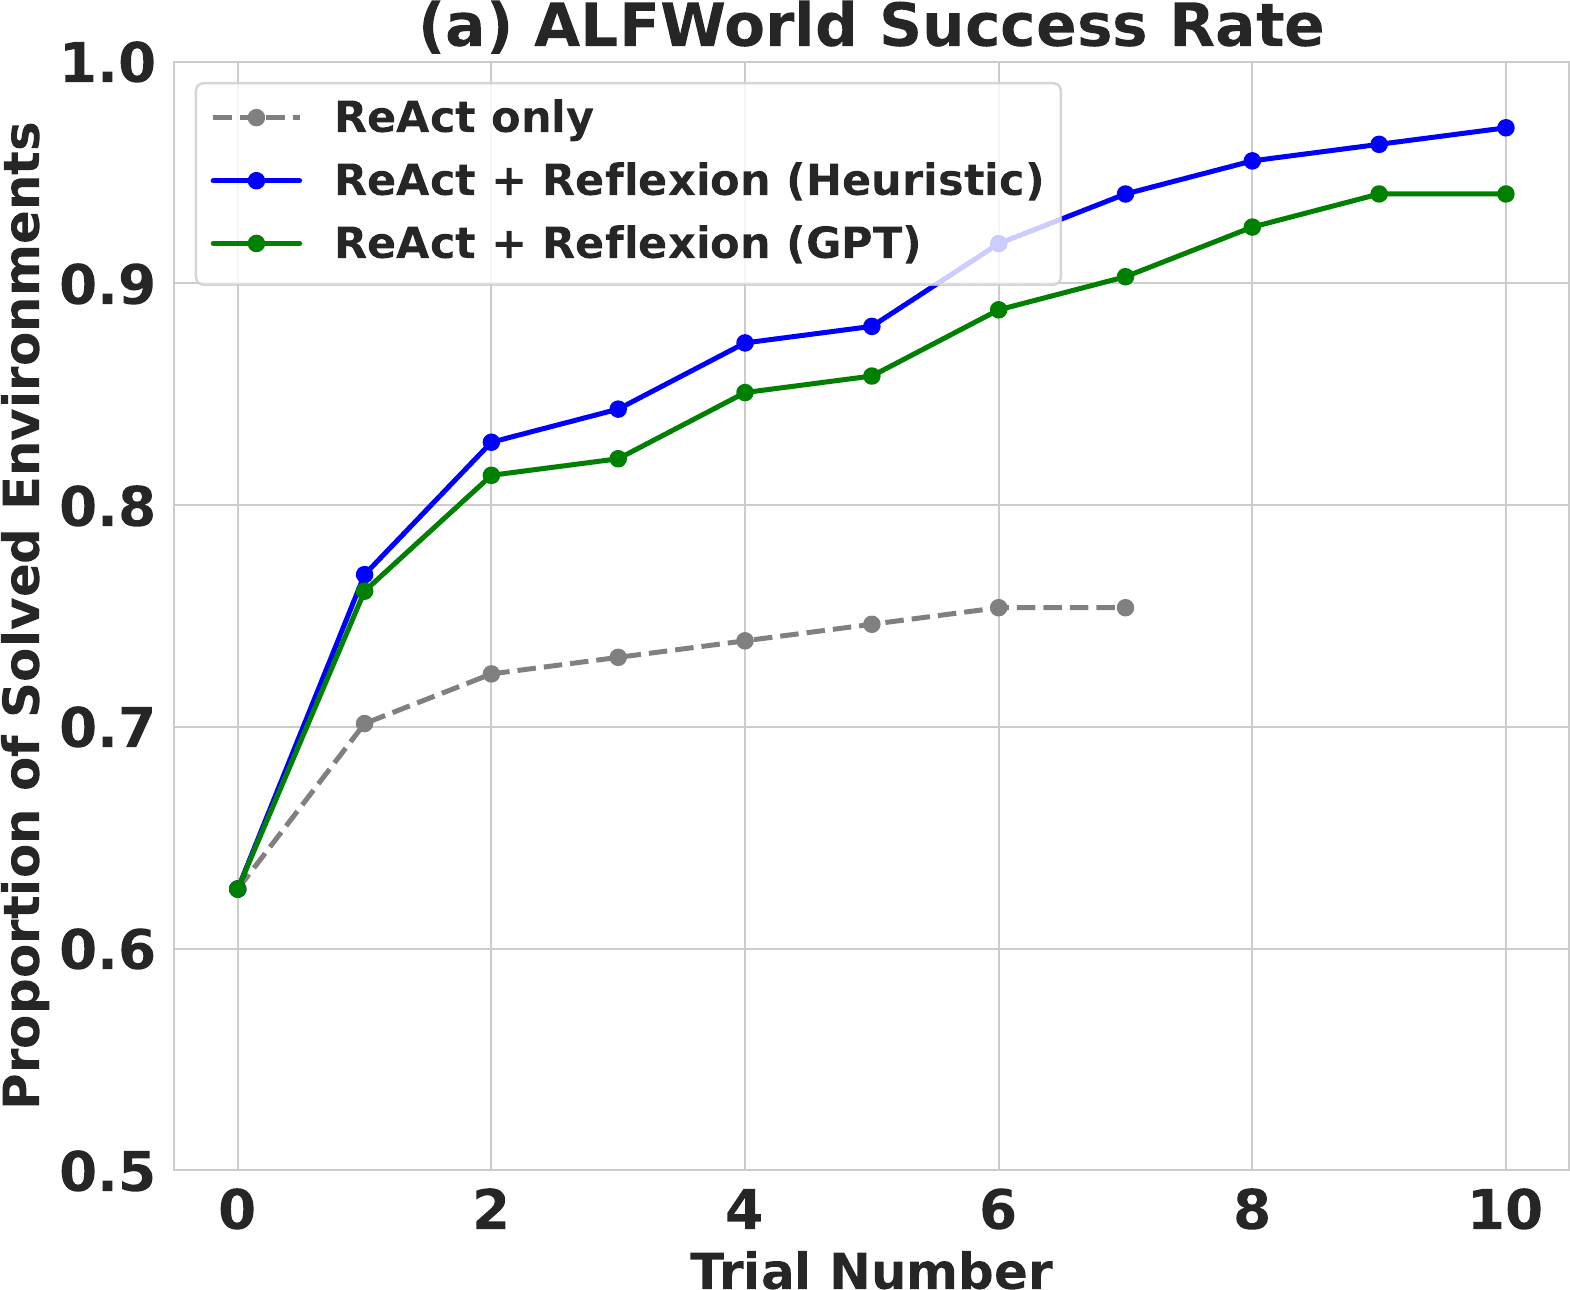
ALFWorld 包含文本化家庭环境中的多步任务。论文沿用 ReAct 作为动作生成器,在 134 个环境、6 类任务上测试。环境只在任务完成时给出信号,因此作者增加两种触发反思的自评价器:GPT 二分类器,或一条简单启发式——同一动作与同一响应重复超过 3 次,或当前轨迹超过 30 个动作,就判定出现幻觉或低效规划。
最强的 ReAct + Reflexion(启发式)最终完成 130/134 个任务,约 97%;纯 ReAct 在第 6–7 轮后基本停滞,而 Reflexion 在 12 次连续试次中继续吸收经验。典型失败是 Agent 误以为自己已经拿到物品,之后在错误前提上持续行动;反思会把长轨迹压成“物品其实不在 stove burner 1,下一轮应搜索其他容器”这样的自我提示。
这组实验说明 Reflexion 最适合可以重置、可以验证、错误具有可操作替代方案的环境。它不是在单条轨迹里回溯,而是在多次 episode 之间做快速策略迭代。
05 · HotPotQA
知识推理:二元对错也能被放大成可用经验
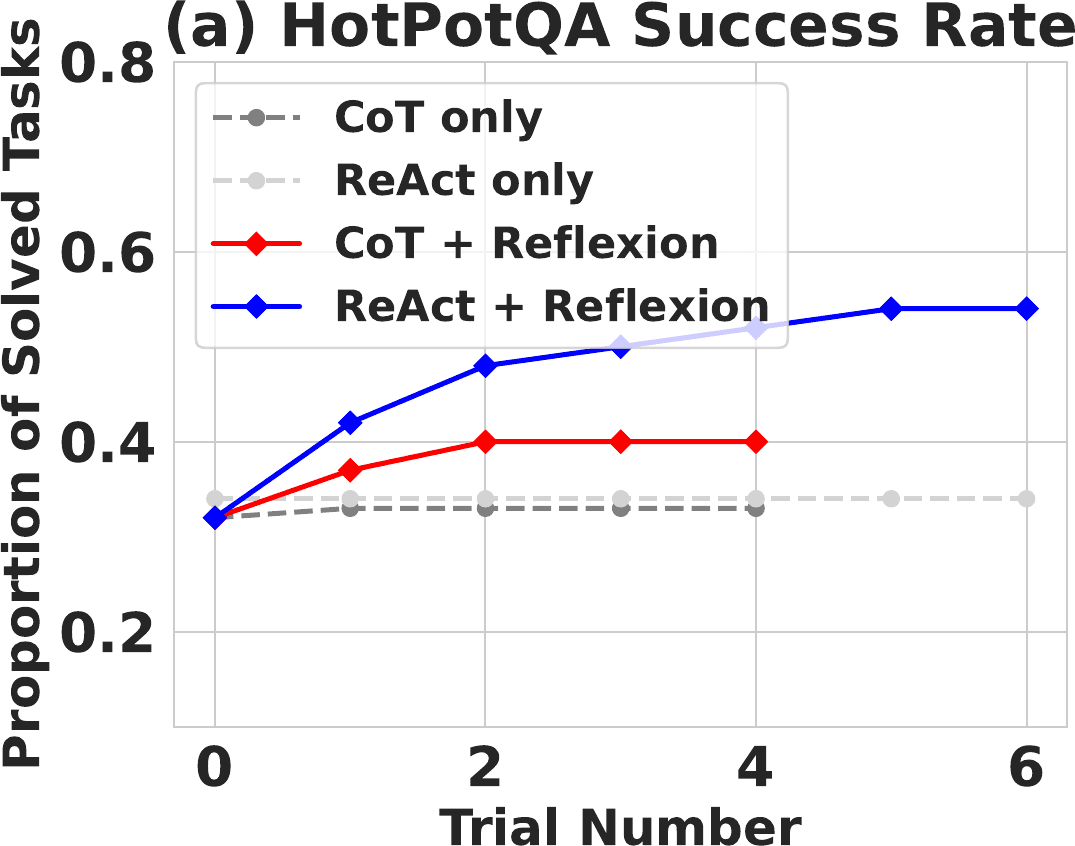
论文在 100 道 HotPotQA 上分别测试 CoT 与 ReAct。CoT 用给定上下文隔离推理能力;ReAct 还要通过 Wikipedia API 检索证据。每轮只用 exact match 产生正确/错误二元信号,Self-Reflection 再结合失败答案与轨迹说明错误原因,记忆上限同样是 3 条。
完整 ReAct 的解题率从约 34% 提升到 54%,即 20 个百分点的绝对增益;只考给定真实上下文的 CoT(GT)时,Reflexion 也让准确率提高 14 个百分点。这说明增益不全来自搜索:当证据已经给定,文字化错误归因仍能帮助模型修正推理。
但曲线也揭示了另一面:几轮之后收益迅速饱和。Reflexion 能在有限候选错误中修正假设,却不会凭空补足缺失知识,也不保证逃出由错误评价或错误反思形成的局部最优。
06 · Programming
代码生成:测试负责指出失败,反思负责把失败变成修复
代码任务提供了最扎实的评价器:编译器、解释器和单元测试。Actor 先生成实现,再由模型最多生成 6 条测试;系统用 AST 过滤语法无效的测试并执行测试套件。若失败,Self-Reflection 根据实现、报错和测试结果写出诊断,下一轮 Actor 只读取最近 1 条经验后修复代码。因为没有访问基准隐藏测试,这一流程仍符合 pass@1 的评测口径。
HumanEval Python 的结果最醒目:GPT-4 单次生成 80.1%,Reflexion 达到 91.0%。在 50 道最难的 HumanEval Rust 子集上也从 60% 提到 68%。但 MBPP Python 从 80.1% 降至 77.1%,提醒我们:测试驱动闭环的上限由自生成测试的质量决定。
| 基准 / 语言 | GPT-4 单次生成 | Reflexion | 变化 |
|---|---|---|---|
| HumanEval / Python | 80.1 | 91.0 | +10.9 |
| HumanEval / Rust | 60.0 | 68.0 | +8.0 |
| MBPP / Python | 80.1 | 77.1 | −3.0 |
| MBPP / Rust | 70.9 | 75.4 | +4.5 |
| Leetcode Hard / Python | 7.5 | 15.0 | +7.5 |
07 · Ablation
不是“多跑几次”:测试生成与语言反思缺一不可
作者在最难的 50 道 HumanEval Rust 上拆掉两块组件。没有测试生成、只让模型自我反思,准确率从 60% 基线降到 52%——模型不知道当前实现是否已正确,会在每一轮继续做有害修改。保留测试但删掉自然语言反思,结果仍是 60%,说明编译错误和测试失败虽然指出“哪里有问题”,却不会自动转化为有效修复策略。
只有测试生成与自我反思同时存在时才达到 68%。Evaluator 提供锚点,Reflection 完成信用分配,Actor 执行修改;少掉任何一环,循环就退化为带噪声的重采样。
| 方法 | 生成测试 | 语言反思 | Pass@1 |
|---|---|---|---|
| 基础模型 | 否 | 否 | 60% |
| 省略测试生成 | 否 | 是 | 52% |
| 省略自我反思 | 是 | 否 | 60% |
| Reflexion | 是 | 是 | 68% |
08 · Failure Modes
什么时候反思会失效:评价错、模型弱、环境不可验证
- 测试假阳性HumanEval Python 的自生成测试假阳性率仅 1.4%,MBPP Python 却达到 16.3%。错误实现一旦通过了错误测试,Agent 会提前停止;这直接解释了 MBPP 的负收益。
- 能力门槛附录使用 StarChat-beta 时,基础模型与 Reflexion 都是 26%。作者据此判断,能提出有效自我修正是更强、更大模型才出现的能力;反思不是免费的能力放大器。
- 任务不匹配附录 WebShop 的 100 个购物请求中,ReAct + Reflexion 没有显著优于 ReAct。开放环境里的目标与失败原因更分散,旧经验难以迁移到下一条不同请求。
- 局部最优自然语言策略优化仍可能困在非最优解;如果模型持续形成同一错误解释,有限滑动窗口只会重复强化它,没有收敛保证。
- 工程边界非确定函数、外部 API、硬件相关输出、并行与并发程序难以靠输入输出测试准确判定;论文也特别提醒,自动执行模型生成代码必须放在隔离环境中。
09 · Interpretation
它叫“语言强化学习”,但更新的其实是上下文策略
Reflexion 借用了强化学习的 episode、reward、policy optimization 语言,但它与基于梯度的 RL 有本质区别:模型权重不变,没有价值函数或策略梯度,经验也只在当前任务的有限上下文中生效。论文把策略参数写成模型 M 与记忆 mem 的组合;所谓“学习”,就是持续改写 mem,让同一个模型在下一轮条件分布下采取不同动作。
因此更准确的工程理解是:Reflexion 是一种带持久状态的测试时策略改进。它的优势是轻量、可解释、能接收丰富文本反馈;代价是上下文成本、评价器依赖、容易受错误记忆污染,而且学到的经验不一定跨任务迁移。它不是 RL 微调的低成本等价物,而是一条不同的适应路径。
10 · Commentary
点评:真正留下来的不是“反思”提示词,而是闭环接口
如果只把 Reflexion 理解成在提示词末尾加一句“反思错误”,就会错过它的工程价值。有效系统需要四个可观测接口:完整轨迹、可信评价、结构化复盘、可控记忆;还要有明确的停止条件。论文的消融已经说明,缺少评价或缺少归因,反复生成都不会自然变成学习。
对今天的 Agent 产品,最值得复用的设计是把失败日志加工成下一轮可执行约束:代码 Agent 用测试与编译器,浏览器 Agent 用页面状态断言,数据 Agent 用 schema 与结果校验。反思文本应短、具体、指向替代动作,并带来源和有效期;否则记忆越多,只是把上下文变成更昂贵的错误缓存。
这也是 Reflexion 的分水岭:在反馈便宜而可靠、任务允许重试、错误可归因的场景,它能用零权重更新换来显著收益;在评价模糊、每轮任务变化大或失败不可逆的场景,先投资 Evaluator 与安全回滚,通常比堆更多“自我反思”更重要。
这篇论文最持久的影响,是把 Agent 的一次失败定义成一种可存储、可检查、可再次消费的数据结构。